
2026年4月9日、GTO Wizardの公式Xからこのようなポストが投稿されました。
GTO Wizardが今回公開したのは、ポーカーを使ってAIの実力を比較できるベンチマーク環境です。
各AIを共通の対戦相手であるGTO Wizard AIと対戦させ、その成績を数値化します。
本記事では、このベンチマークの仕組みと、そこから見えてきたAIの現状と今後の展望について整理します。
2026年10月16日更新:公式リーダーボードの追加モデルと、評価方法の説明を反映しました。
GTO Wizardの基本機能は、以下の記事で紹介しています。
GTO Wizardが公開した新しい
ベンチマークとは
ベンチマークとは、同じルールで性能や強さを測り、比較できるようにするための仕組みです。
つまりGTO Wizardが公開したのは、ポーカーを用いてAIの強さを測るための対戦環境です。
各AIがGTO Wizard AIと同じ条件で対戦するため、共通の相手にどこまで通用するかを比較できます。
AIの強さを測る評価環境
注目すべきは、共通の対戦相手と評価方法で、AIのポーカー能力を比較できる点です。
ポーカーAIの評価には従来からSlumbotなどの先例があり、今回が初めての取り組みというわけではありません。
評価結果は公開されており、自作AIでの対戦にはAPIキーの申請と承認が必要です。
対戦用のスターターコードも公開されています。
ベンチマークの詳細
ベンチマークは、対戦・成績公開・統計評価を組み合わせた仕組みです。
- 公開API
承認されたAPIキーで、自作AIを
GTO Wizard AIと対戦させる仕組み - ライブリーダーボード
運を補正した成績や対戦ハンド数を
確認できるランキング - AIVAT分散低減評価
運による成績のばらつきを抑える
統計手法 - GitHubスターターコードと
APIドキュメント
AIポーカー参加者用の“開発キット一式”
自作AIを共通の条件で評価するための窓口が設けられました。
ただし、GTO Wizard AI本体のソースコードや、ソルバー機能へのアクセスを公開するものではありません。
どのようにAIの強さを測るのか
評価は、GTO Wizard AIとの対戦成績をもとに行われます。
対応する形式は2人対戦のノーリミットテキサスホールデムで、スタックは毎ハンド200BBにリセットされます(2026年10月時点)。
その際、AIVATという統計手法で運によるばらつきを抑えます。
ポーカーは短期的には運の影響が大きいゲームのため、数ハンドの勝敗では実力は判断できません。
主な指標は運を補正した勝率(Luck-adjusted win rate)です。
単位のbb/100は100ハンドあたりの平均損益をBBで表し、プラスなら勝ち越し、マイナスなら負け越しを意味します。
ただし、補正後も推定の誤差は残ります。
一つひとつの判断を正誤判定する点数ではないため、成績とあわせてハンド数や誤差の大きさを見る必要があります。
なぜポーカーで測るのか
そもそも、なぜポーカーなのでしょうか。
その理由は、ポーカーが見えない情報のもとで判断するゲームだからです。
- 相手の手札が見えない(不完全情報)
- 確率を前提とした意思決定
- ブラフや読みといった心理要素
チェスや将棋のように盤面が丸見えのゲームとは根本的に違い、ポーカーでは「正解がわからないまま判断を下し続ける」ことが求められます。
そのため、単純な計算スピードだけではなく、推測と戦略を組み合わせた判断力が問われます。
こうした特徴からポーカーは、AIの“思考力”を測る指標として使われているのです。
ポーカーにおけるAIの弱点
ではなぜ、検証された汎用AIはGTO Wizard AIに苦戦したのでしょうか。
GTO Wizardの公式論文の分析から、戦略と情報の扱いに関する課題を3つの観点で整理します。
①汎用AIとポーカー専用AIの違い
ポーカーでは、その後のベッティングまで見据えた戦略が求められます。
論文の実験では、LLM系のAIに外部ツールや勝率計算機を与えず、モデル自体の推論でプレイさせています。
評価されているのは、その条件でのポーカー能力です。
一見筋の通った説明ができても、長期的な平均損益である期待値(EV)を高めるプレイとは限りません。
なお、ハンドごとにスタックを戻す実験のため、数百ハンド先のチップ量を予測する課題ではありません。
LLM系のAIとは
LLM系のAIとは、「大規模言語モデル(Large Language Model)」を基盤とするAIのことです。
大量の文章データをもとに学習し、人間のように文章の理解や生成、会話などを得意とします。
ChatGPTやClaudeなどがこれにあたります。
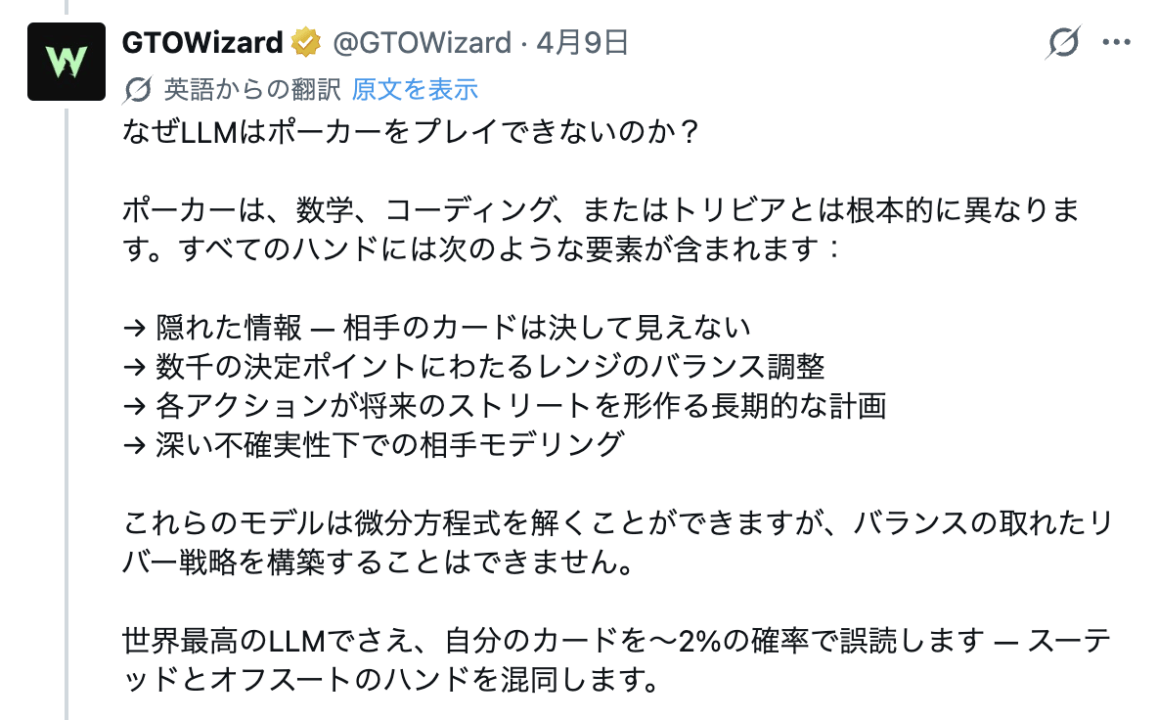
GTO Wizardは2026年4月の投稿でも、見えない情報や、後のベッティングにつながる判断の難しさを挙げています。
②相手の“見えない情報”の扱いが弱い
ポーカーでは、相手の手札という重要な情報が公開されていません。
そのため、プレイヤーは相手の行動や傾向から、どのようなハンドレンジ(持ち得る手札の候補)かを推測する必要があります。
人間のプレイヤーは経験をもとに、「この相手はブラフが多い」「このベットサイズは本手の可能性が高い」といった読みを自然に行っています。
論文では、検証したLLMにレンジ全体を踏まえた判断の不足が見られたと分析されています。
加えてGPT-5.3では、手札が同じスートかどうかを取り違える例も報告されました。
相手の手札を推測する以前に、自分のカードを正しく把握する点にも課題があったことになります。
③一貫した確率戦略の維持が苦手
ポーカーでは、同じ手札でも複数のアクションを一定の割合で使い分ける戦略があります。
- 確率に基づく意思決定
- ブラフとバリューベットのバランス
- 状況ごとに変化する最適解
こうした不確実性が常に存在する環境です。
論文では、LLMのレイズやフォールドの頻度の偏りが指摘されています。
ただし、論文で使用した対戦相手は各AIの癖に合わせて戦略を変える設計ではないため、この結果だけで弱点の突かれやすさまで測り切れるわけではありません。
公開時の結果──有名AIも苦戦
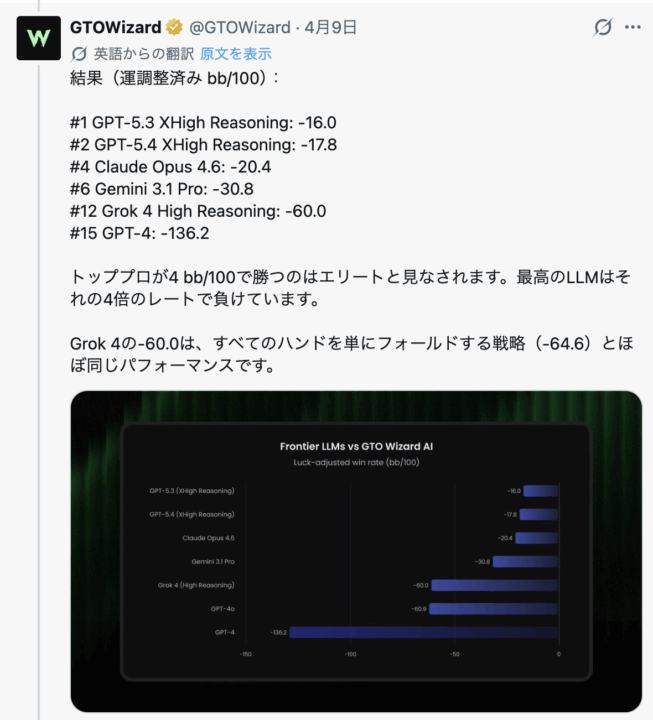
公開時の検証では、対象となったLLMはいずれも負け越しとなりました。
上の画像は2026年4月の発表内容で、現在の全モデルの順位を示すものではありません。
文章の生成や対話で使われるモデルであっても、この条件のポーカー対戦では苦戦しました。
会話の流暢さと、ポーカーで高い成績を残す能力は分けて捉える必要があります。
漠然と「AIは万能」と思われがちですが、どの領域でどこまで通用するのかが数値で示された意義は大きいといえます。
2026年10月追記|新しいモデルの結果
2026年10月16日に確認した公式リーダーボードでは、GPT-6などの結果も追加されています。
以下はいずれもGTO Wizard AI Version 2に対する、運を補正した成績です。
- GPT-6 (Low Reasoning):−5.4 bb/100/10,000ハンド
- GPT-6 (XHigh Reasoning):−8.8 bb/100/10,000ハンド
- GPT-5.5 (XHigh Reasoning):−9.2 bb/100/5,000ハンド
追加されたこれらのモデルも、確認時点の成績はマイナスでした。
ただし、推論設定やハンド数、推定の誤差が異なるため、数値の小さな差だけで優劣を断定することはできません。
5,000ハンドで十分か?
AI評価に必要な試行回数は?
GTO Wizardの公式論文では、各モデルと5,000ハンドのヘッズアップ・ノーリミットテキサスホールデムで対戦した結果が報告されています。
この5,000ハンドという試行回数について、トム・ドワン(Tom Dwan)さんは2026年4月10日のXで、5万〜10万ハンドでの再検証を求めていました。
This is cool. 5k obviously not enough hands though, you guys should know that. Can you run a new one with 50-100k hands 🙏🏻🙏🏻 https://t.co/Wfzdmo66PM
— Tom Dwan (@TomDwan) April 10, 2026
一方、GTO Wizardの公式論文では、AIVATの利用により、通常の集計と同程度の統計的な確かさを得るためのハンド数を約10分の1に減らせると説明されています。
このため、5,000ハンドという数だけでは評価の妥当性は決まりません。
必要な試行回数は、測りたい成績の差によっても変わります。
推定値と誤差、対戦条件をあわせて確かめると、結果をより正確に読み取れます。
まとめ|本質は
「AIの強さを測る基準」ができたこと
GTO Wizardの今回の発表は、単なる新機能ではなく、AIの実力を測る新たな基準を提示した点に大きな意味があります。
共通の相手と対戦し、運を補正した成績やハンド数を公開することで、AIのポーカー能力を継続して比較できます。
追加モデルの結果は、公式リーダーボードで確認できます。
今回の結果が示したのは、検証された汎用AIと専用ポーカーAIの間には、なお成績の差があるという点です。
「AI全般がポーカーを苦手としている」という意味ではありません。
このベンチマークを通じてAIのポーカー能力がどこまで進化していくのか、そしてポーカーという競技がどのような役割を果たしていくのか、今後の動向が注目されます。
GTO Wizardの基本機能を知りたい方は、以下の記事も参考になります。
コメント